文档核对版本: 1.0.12 · 2026-09-23
从校验后的 mass_dataset 开始,准备样品用途、批次和进样顺序。先过滤缺失过多的 feature,再填补。异常样品应结合实验记录判断,不能自动删除所有 PCA 离群样品。
impute_mv() 提供 kNN、随机森林、简单值和模型填补等方法,按缺失机制和数据规模选择样品范围与方法。normalize_data() 提供 total、mean、median、PQN 样品级方法和依赖 QC 的 SVR/LOESS;后两者需要合适的 QC 覆盖和采集信息。integrate_data()、align_batch() 处理支持的跨批次任务,但不能消除批次与生物学分组完全混杂的设计问题。
保留输入对象,检查处理后的缺失情况、QC 指标及前后图。预测建模时在训练折内部拟合预处理,避免信息泄漏。下例的中位数填补和归一化仅用于展示 API。
图解:本章操作路线
先保存未修改对象,查看哪些行不满足缺失率条件,再填补保留数据中的缺失值。标准化后比较强度分布和 QC 表现,并记录方法及排除 ID;填补值不是独立观测到的峰。
功能范围
异常样品检测与报告、缺失值填补、样品级/QC 归一化、LOESS 参数优化、批次对齐与整合。
使用示例
# object is the mass_dataset created/imported in the previous chapter.
expr <- massdataset::extract_expression_data(object)
keep <- which(rowSums(!is.na(expr)) > 0)
stopifnot(length(keep) > 0)
object <- object[keep, ]
cleaned <- masscleaner::impute_mv(object, method = "median")
normalized <- masscleaner::normalize_data(cleaned, method = "median")
saveRDS(normalized, "normalized.rds")
函数查询
下面列出已核对源码中导出的 API,包括兼容接口与辅助函数。具体参数以安装版本的 R 帮助为准;例如运行 help("函数名", package = "masscleaner")。
展开导出函数列表
align_batch, check_for_data_integration, check_for_qc_normalization, detect_outlier, extract_outlier_table, get_masscleaner_version, impute_mv, integrate_data, masscleaner_conflicts, masscleaner_logo, masscleaner_packages, normalize_data, normalize_data_pqn, optimize_loess_span
看图操作:比较强度分布
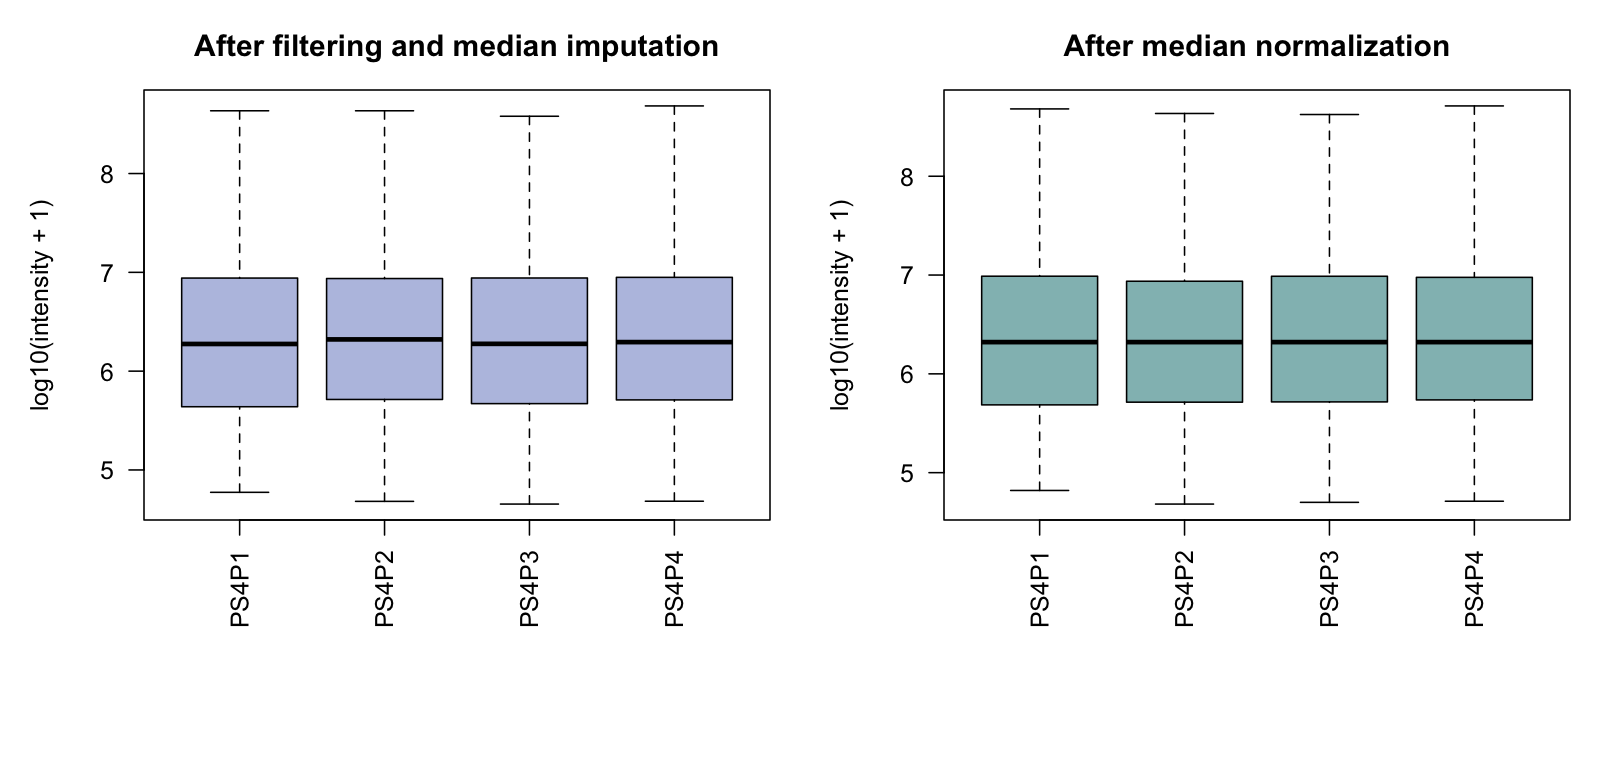
- 两图展示 log10(intensity + 1),左图输入已经过滤和填补。
- 右图为中位数标准化后的结果。中位数接近是该方法的预期结果,不是技术偏差已消除的独立证据。
- 在真实数据中选择标准化方法前,核对实验设计,并在有合适定量 QC 时检查其表现。