返回教程目录 · 适用版本:0.1.63
图解:本章操作路线
把原始文件基本名列出来,与 sample_id 对照,先解决重复、缺失及意外文件。生物学分组与 class 分开填写:QC、Blank 描述样本用途,Control、Treatment 描述比较分组。
原始数据
非靶向工作流和 Raw chromatograms 使用 mzML / mzXML。本版本这些入口不直接处理厂商专有 RAW 文件;请先使用适合仪器和采集方式的转换工具。
正、负离子模式建议分别建立项目。文件名去掉扩展名后必须唯一,即使文件在不同子文件夹中也不能重名。不要只用大小写区分样品名。
导入会登记文件位置,后续需要检查 EIC 或质谱时仍可能使用原始文件。因此不要在分析过程中移动、替换或重命名它们。
sample information
原始数据导入支持 CSV、TSV、Excel 样品信息。示例:
sample_id,group,class,batch,injection.order,subject_id
S001,Control,Subject,B1,1,P01
S002,Treatment,Subject,B1,2,P02
QC001,QC,QC,B1,3,
Blank001,Blank,Blank,B1,4,
| 列 | 含义与要求 |
|---|---|
sample_id |
与原始文件名去掉扩展名后完全一致。例如 S001.mzXML 对应 S001 |
group |
生物学分组;如果列名不同,在 Group column 中指定实际列名 |
class |
样品用途,例如 Subject、QC、Blank |
batch |
分析批次,用于检查批次效应等 |
injection.order |
进样顺序,用于漂移检查及需要顺序信息的方法 |
subject_id |
配对分析中的个体标识,不配对时可以不提供 |
导入原始文件时,样品信息必须覆盖所有选中的文件,每个 sample ID 只能出现一次。不要用表格行号代替样品名。前导零应保留为文本,例如 001 不能变成 1。
建议明确填写 class,不要依赖自动推断。用于收集 MS2 的 pooled QC 不是自动等同于用于定量质量评价的 QC;只有符合定量实验设计的 QC 才应进入相应 QC 计算。
已有峰表
通过 Dataset builder & converter 将峰表构建为 mass_dataset,再用于独立分析模块。宽表格式示例:
variable_id,mz,rt,S001,S002
F001,100.1234,60,1000,1200
F002,200.2345,120,500,NA
variable_id唯一。mz为离子质荷比,rt的单位与所选导入选项一致;上例为秒。- 强度列名与样品信息的
sample_id对应。 NA表示缺失。零是实际数值,不会自动当作缺失值。- 元数据中的注释名称不应被当作已确认鉴定,需保留其证据来源。
MS2 数据
MS2 可在支持的导入、数据构建或注释入口附加。MS2 与 feature 的关联依赖前体 m/z 和 RT 等条件;有匹配的 MS2 不代表已确认化合物身份。
开始前用 Sample & file checker 排查重复、缺失和未预期的文件,尤其适合多批次项目。
看图操作:理解特征行与样本列
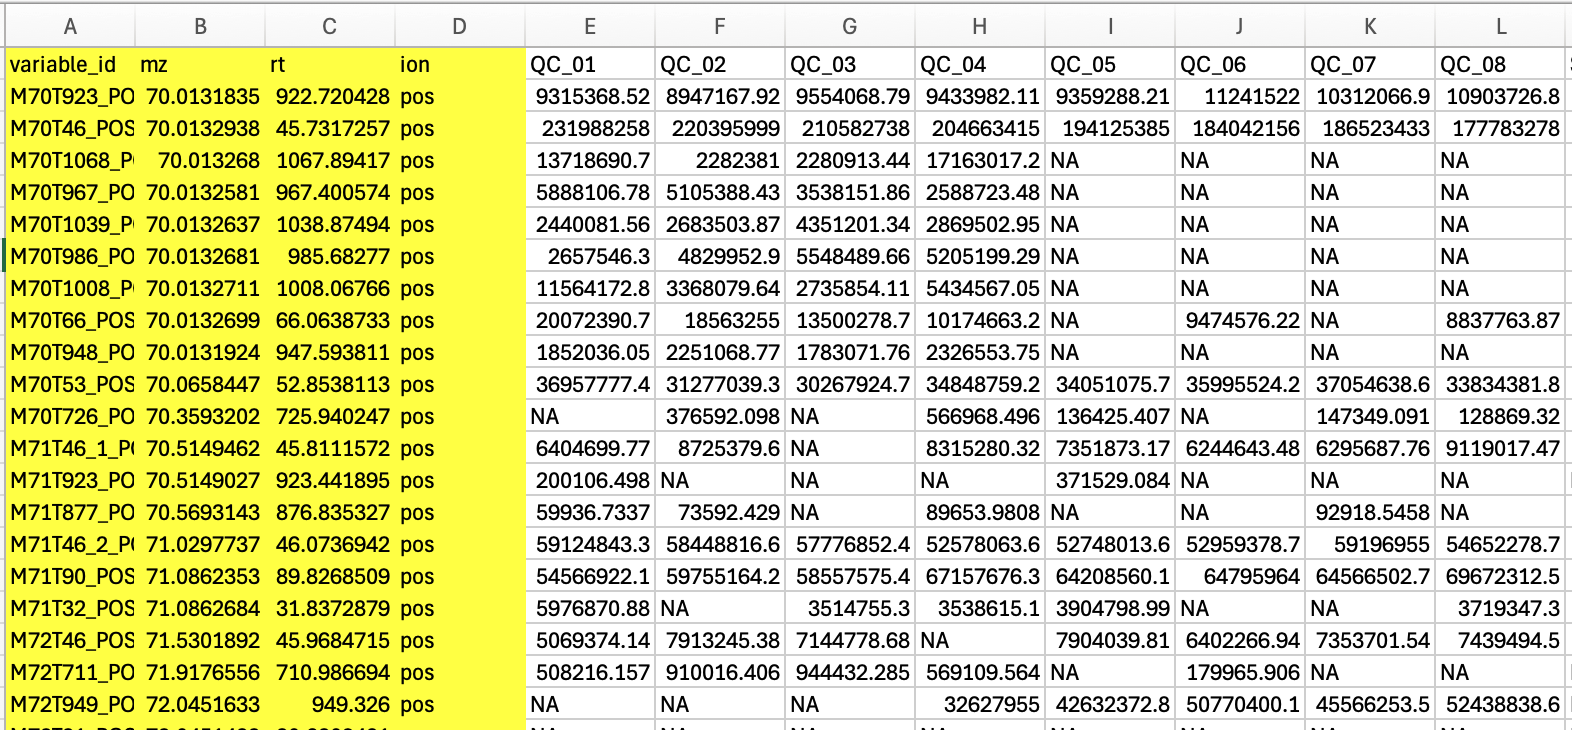
- 每行代表一个具有 ID、m/z 和 RT 的特征,样本列保存强度。
- 桌面峰表导入应遵循相应模板字段;ion 的处理与 Shiny 导入器不同。不要把元数据列当成强度列。
- 让每个强度列对应样本表的一行,导入前检查缺失值。