依据现有公开教程和 tidymassshiny 1.0.0 公开源码整理,核对日期:2026-09-23。
图解:本章操作路线
先阅读对应工具的输入面板。fMSEA 使用特征层输入进行模块分析,化合物通路富集使用映射后的化合物 ID。保存参数与映射输出;可选语言模型解读不能替代实验证据。
fMSEA
进入 Tidymass shiny toolkits → fMSEA Analysis。加载要求的 R 数据文件:处理后的 Feature Table、支持的 KEGG/HMDB MS1 Database 和 Pathway Database。公开模块列出 KEGG、HMDB、IMETPD、Reactome、WikiPathways 资源。按模块 demo 的对象结构准备,不能给任意 CSV 改扩展名后上传。
- Run Step 1:设置色谱、数据库类型、MS1 ppm、RT 聚类容差和同位素数。进入富集前查看候选分配。教程示例为 15 ppm、10 s、三个同位素,自己的数据需调整。
- Run Step 2:设置线程、通路最小/最大规模、置换次数、迭代次数和 FDR。公开默认值包括 1,000 次置换、通路规模 15–300;这些是计算选项,不保证最优。
- 在 Significant Modules Table 选择一行查看富集得分曲线。保存完整结果与设置,不只保存显著图。
已有相容结果对象可以直接导入查看,跳过步骤 1–2。Feature 富集仍包含候选分配不确定性,不能据此确认所有参与化合物。
可选 LLM 评估
模块提供基质相关性和文献相关性评估。填写样品来源或研究主题,配置所选服务的 API,再运行需要的评估。该步骤可选;没有 endpoint/key 就是没有运行。生成的分数不能替代统计验证或核实后的文献证据。使用非公开研究信息前,先确认向服务发送的内容。评估结果与富集表、PNG/PDF 图分别下载保存。
Feature-based Pathway Analysis(FPA)
进入 FPA 工具,准备要求的 feature 数据、离子模式和相容的通路/候选资源。检查当前模块的 feature 分组、同位素/加合物假设、质量容差和零分布/置换选项,运行后审查贡献 feature,并导出模块和参数。metpath 教程说明相关 R 接口及解释边界。FPA 与 fMSEA 是不同方法,分数不能直接混用。
构建自建代谢物数据库
在与研究可比的条件下采集标准品,按 metid 数据库结构准备化合物信息与 MS2。在工具中用 File Path 选择 CSV,检查 Construction Parameters,点击 Build Database。核对 m/z、RT、名称和谱图,使用描述性数据库标识,再 Download Database。
将生成的 .rda 放到专用注释数据库目录,注释时选择它。对象被标成 in-house 不能代替标准品和采集条件核验。
构建物种特异 KEGG 通路库
从 KEGG 物种列表确认代码,例如 hsa、mmu。进入 KEGG Pathway Database Construction,通过 Set working directory 指定工作目录,填写代码和请求间隔(现有教程使用至少一秒),再点击 Download pathway。观察网络错误和输出路径;富集前检查通路 ID 的物种前缀,保存获取日期与物种代码。
代谢物 ID 转换
在 Convert Parameters 选择服务,配置 Source ID Type、Target ID Type,在 Conversion Input 输入查询,再点击 Convert ID。检查失败与一对多映射,不要悄悄删除失败条目。API 服务需要配置凭据。实验性 LLM 转换可能产生错误 ID,进入数据库或通路分析前应独立核对结构和标识。
截图来自现有公开教程。
看图操作:检查功能模块
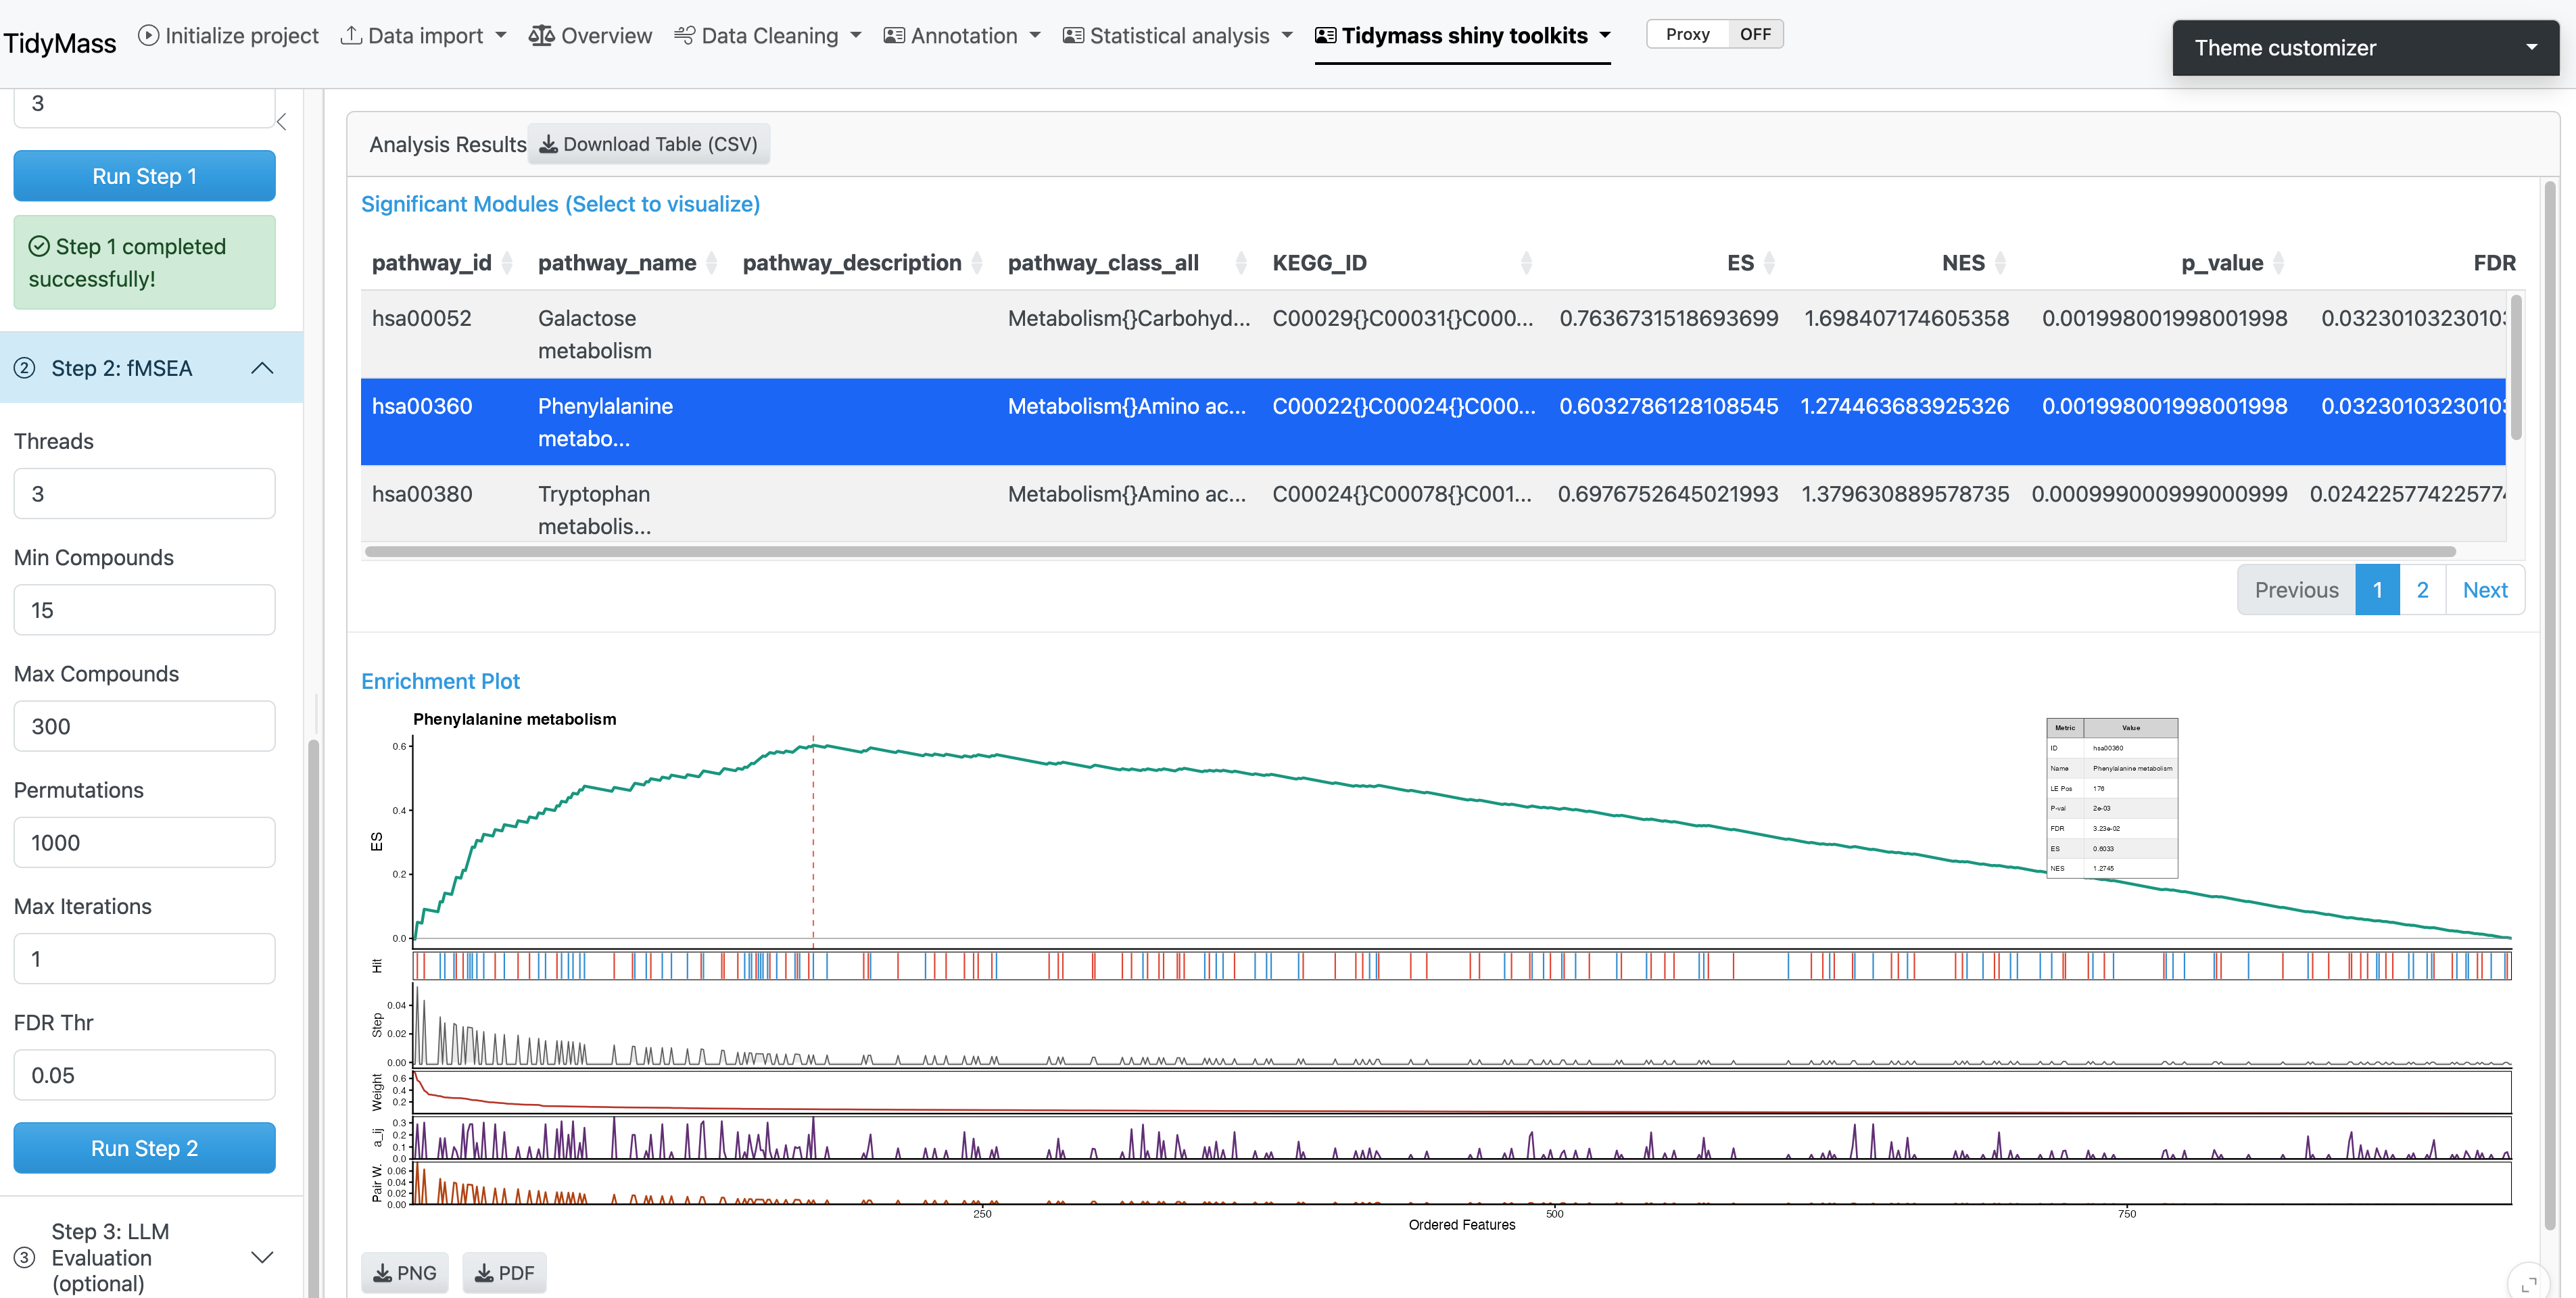
- 完成 fMSEA 所需输入和分析步骤后再打开模块可视化。
- 检查模块中的特征与关系,并比较其统计量和候选注释。图中聚类不自动等于结构确认。
- 保存模块表和可视化设置;可选的自动生成解释应与实测证据区分记录。