依据现有公开教程和 tidymassshiny 1.0.0 公开源码整理,核对日期:2026-09-23。
初始化项目
设置工作目录,上传 sample_info.csv,必要时映射列名,再点击 Initialize Project 并检查样品信息。样品 ID 必须与强度列或原始文件名准确匹配;区分生物学 group、用途 class、批次和进样顺序。
sample_id,group,class,injection.order,batch
S001,Control,Subject,1,B1
S002,Treatment,Subject,2,B1
QC001,QC,QC,3,B1
该表仅展示格式,不代表实验具有足够重复。区分正负模式测量并保留 ID 前导零。
从 MS 文件开始
先将厂商文件转为适用的 mzML/mzXML;厂商读取能力取决于转换器和平台。按文档要求将 MS1 文件放入 QC、Subject 等样品类型目录。
进入 Data import → Start with MS file,选择 SELECT MS1 FOLDER,点击 CHECK INPUT FILE。检查 ppm、peakwidth、snthresh、noise、threads。参数优化只能辅助选择,仍需结合 EIC 和对齐结果判断适用性。确认后开始峰检测并等待完成,不要反复启动同一任务。
在线版需要使用上传流程,将 MS 文件打包成要求的 ZIP,再通过 Process MS1 Files 解压/处理。服务器的目录选择器不能代替上传本机文件。
从峰表开始
选择 Start with table file 并上传 CSV。当前源码允许映射 feature ID、m/z、RT 和 ion 列,初始映射取前四列。可使用如下格式:
variable_id,mz,rt,ion,S001,S002,QC001
F001,100.1234,60,pos,1000,1200,1100
F002,200.2345,120,neg,500,600,550
使用 pos/neg 等支持的模式标识,正确选择 Retention time in;分钟会转为秒。自己的列名或顺序不同时显式映射四个元数据字段,剩余列只保留数值样品强度,并与项目样品表一致。
先点击 Input file summary 核对匹配、模式、样品数和 feature 数,再点击 Generate massdataset object,查看正负模式输出。额外文本注释列可能被当作强度,因此应先移除或通过合适的注释入口导入。
从已有对象开始
选择 Start with mass_dataset file,分别在正负模式入口加载对应对象,再点击 Check input。修改扩展名不能把 CSV 变成 R 对象;保留原对象和包版本记录。
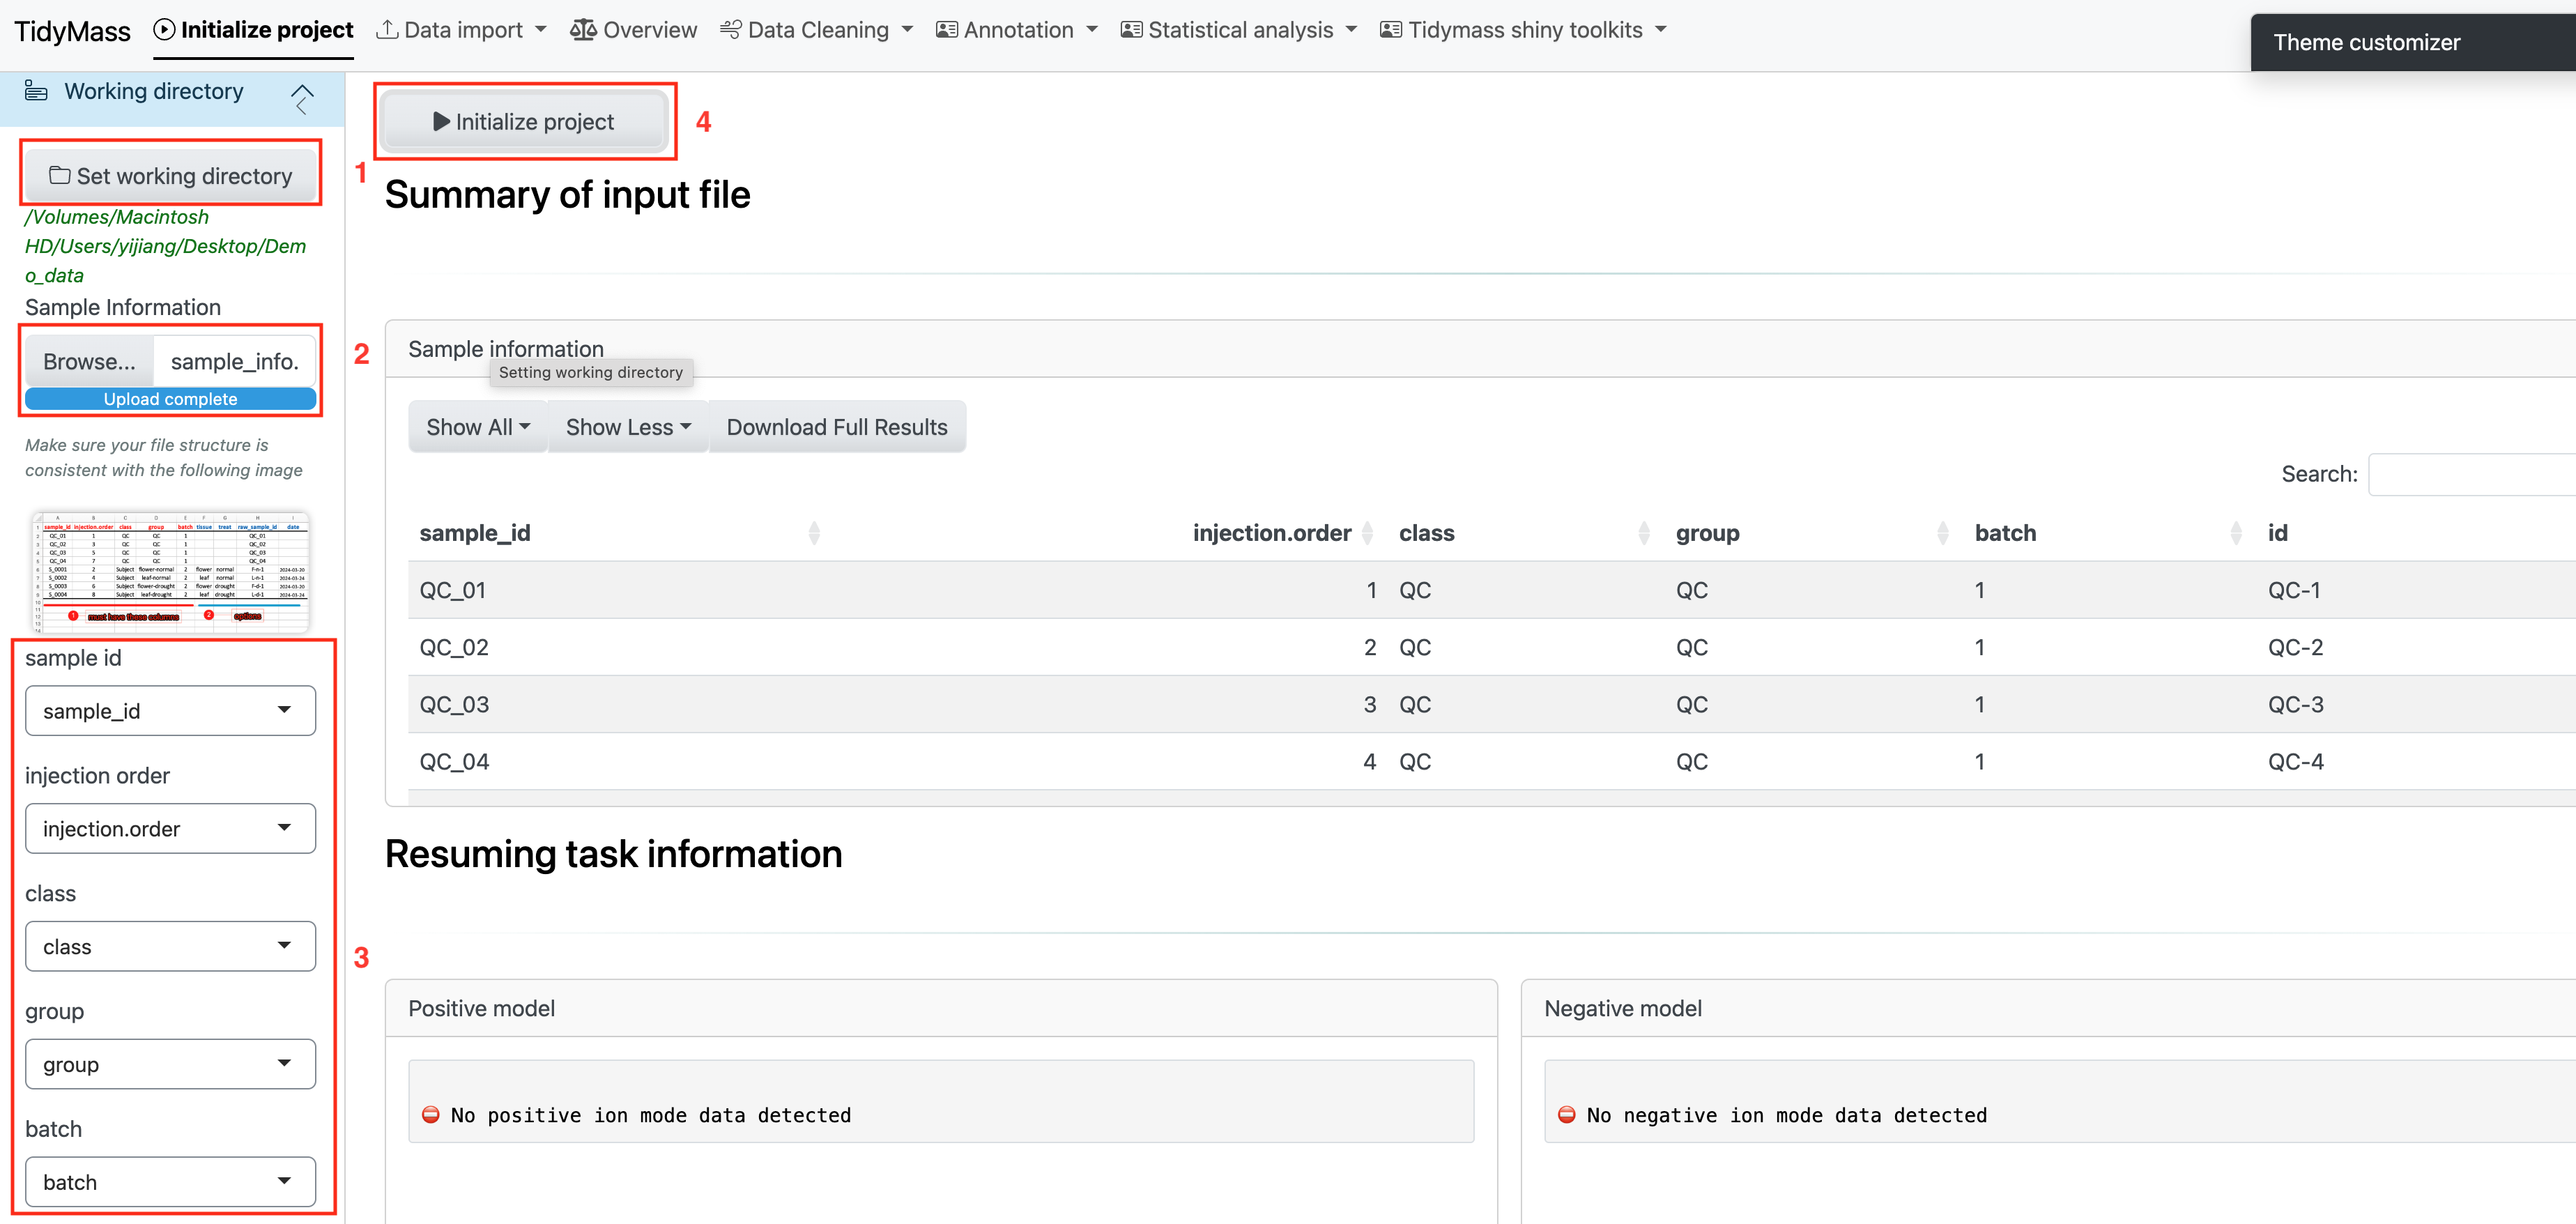
截图沿用现有公开 Shiny 教程,不同部署的界面细节可能不同。