依据现有公开教程和 tidymassshiny 1.0.0 公开源码整理,核对日期:2026-09-23。
图解:本章操作路线
进入每个模块前核对当前对象,依次确认注释证据、比较方向、统计校正和通路物种。示例截图中的数值阈值不能脱离实验设计与数据直接照搬。
关联实验 MS2
通过 Select MS2 folder 选择准备好的 MGF,正负模式分开存放。设置色谱类型、前体 m/z 和 RT 关联容差,再点击 Start。将谱图关联到 feature 的容差,与参考库匹配容差是不同参数。
代谢物注释
将相容参考数据库放在专用目录,用 Choose folder 选择。设置 MS1/MS2 容差、RT 容差、候选数、色谱及线程,只点击一次 Start annotation,观察日志并等待结束。
MoNA、MassBank、HMDB 是公共资源,不自动等于自建标准品库。参考 RT 只在色谱可比时使用。接受名称前审查候选与谱图证据;软件的置信度标签必须结合实际测量解释,MS1 候选不会因为获得某个 level 标签就成为结构确认。
注释筛选与来源查看
选择多候选保留方式、加合物冗余处理和支持的证据等级;适用时设置 Adduct for level 3 annotation,再点击 START。保留筛选前候选表及筛选规则。
在 Metabolites origin 点击 Check database、Start。UpSet 图汇总来源关联及交集,选择化合物后用 Show network plot 查看数据库关系。这些是参考关联,不是样品中实际生物合成来源的证明。
差异分析
点击 Wake up object,选择样品属性并明确对照/参考组。运行后查看 PCA 和火山图,核对 fold change 方向,并区分原始 P 值与 FDR/校正 P 值阈值。保存包含不显著 feature 的完整结果表。
只让目标生物学样品进入检验,不按表格顺序推断配对。如果界面不能表示研究所需的重复测量或协变量,导出对象后使用适当 R 模型。
通路富集
选择 KEGG/HMDB,或用 Upload custom database 加载自己的通路库;检查物种、ID 类型、校正方法、阈值和线程。查看柱状/散点图和 ID 映射覆盖,审查候选歧义、去重化合物 ID 并记录方法使用的背景。富集表示相对参考集合的统计关联,不直接证明通路激活。
截图来自现有公开教程。
看图操作:配置注释证据
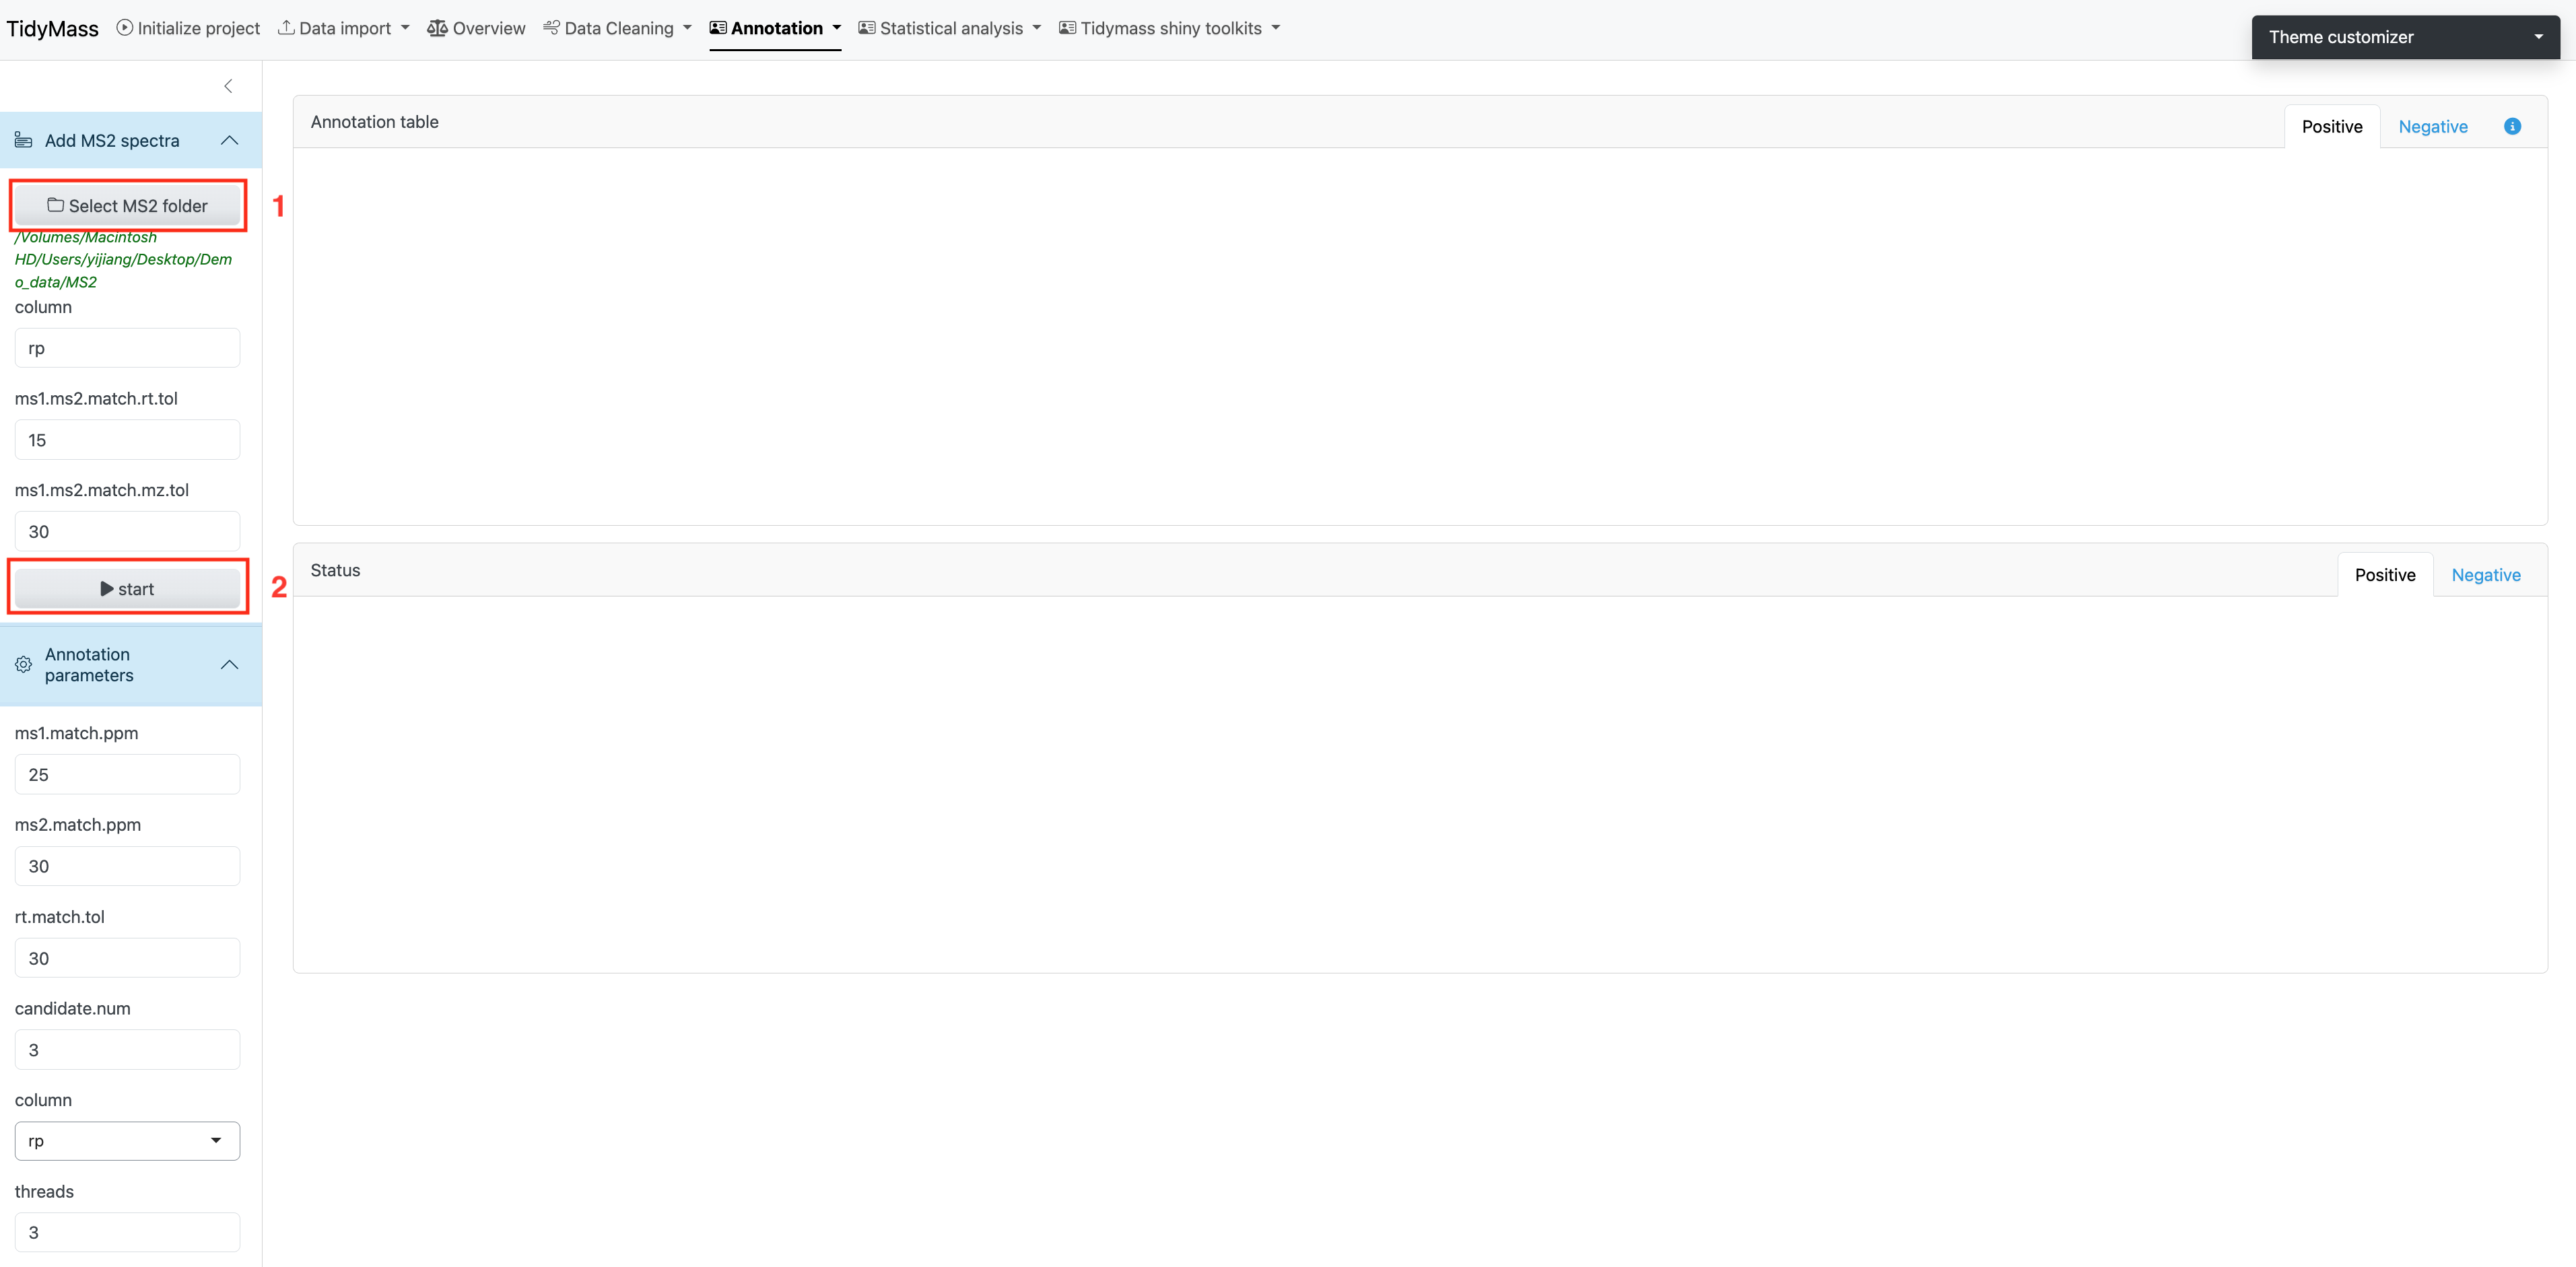
- 选择数据、参考数据库和极性;设置质量与 RT 容差前先确认色谱条件和加合物。
- 运行注释后检查候选层证据。没有实验 MS2 的候选不能描述为 MS2 确认。
- 进入统计前下载包含评分和数据库来源的完整候选表。
看图操作:阅读组间比较视图
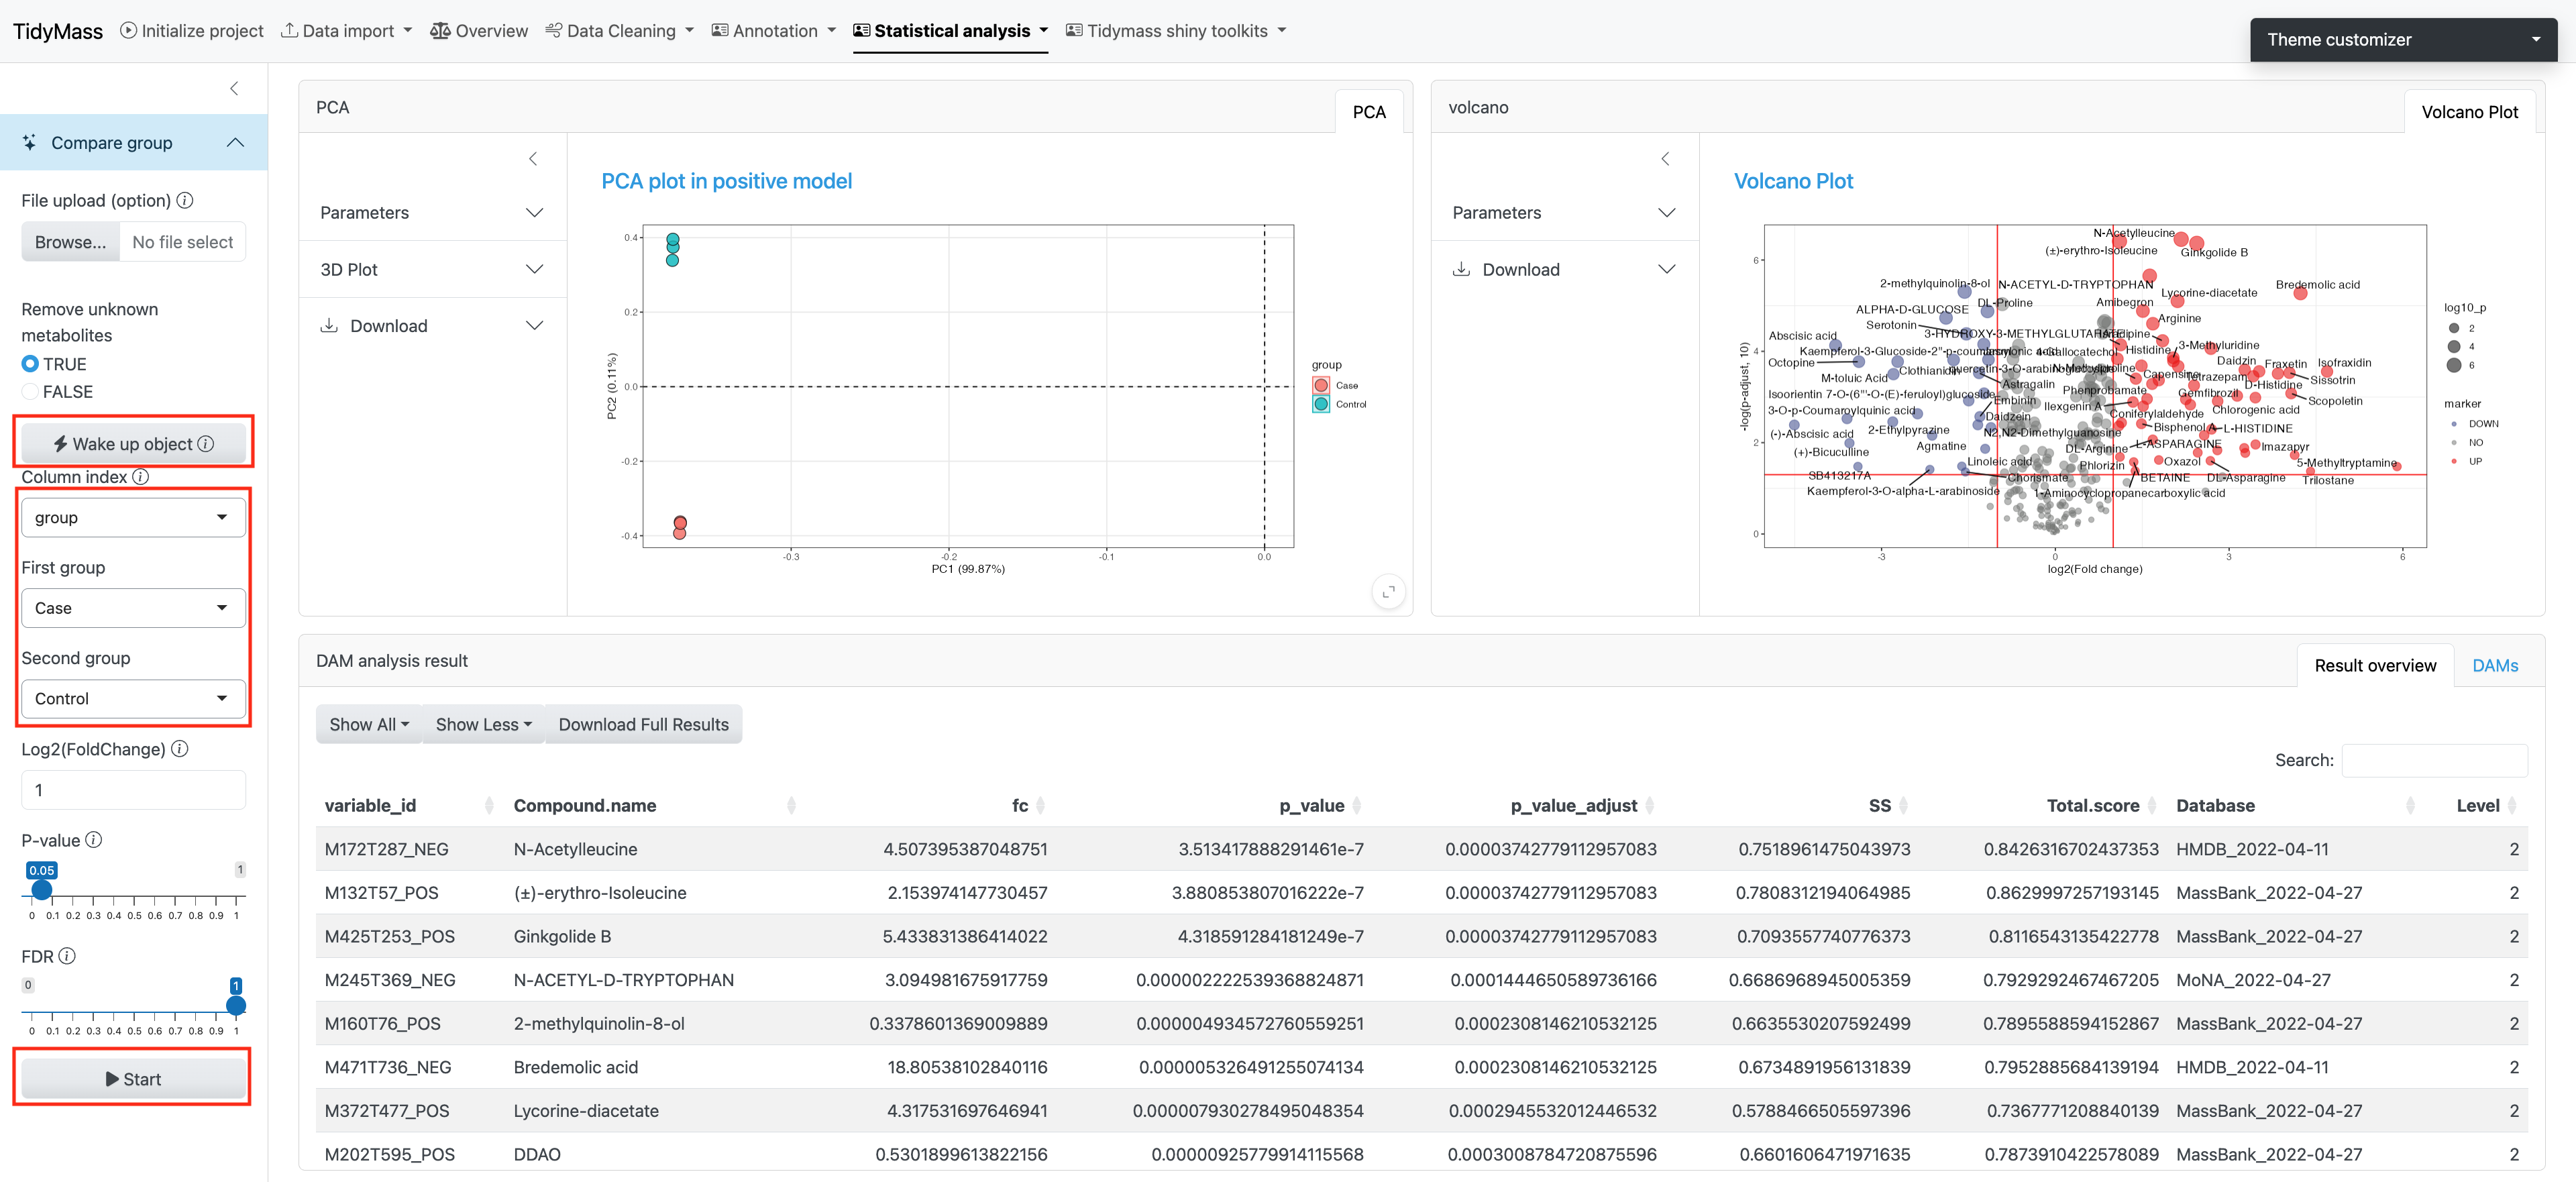
- 核对当前对象和 Column index,再选择 First group 与 Second group,记录当前模块使用的倍数变化方向。
- 根据研究目的设定效应量和统计阈值。截图的 FDR=1 很宽松,不应照搬为推荐发现阈值。
- 点击 Start 后查看完整表,尤其是 fc、p_value 与 p_value_adjust。PCA 用于描述结构;解释火山图突出点前先复核单个峰证据。
看图操作:检查通路富集
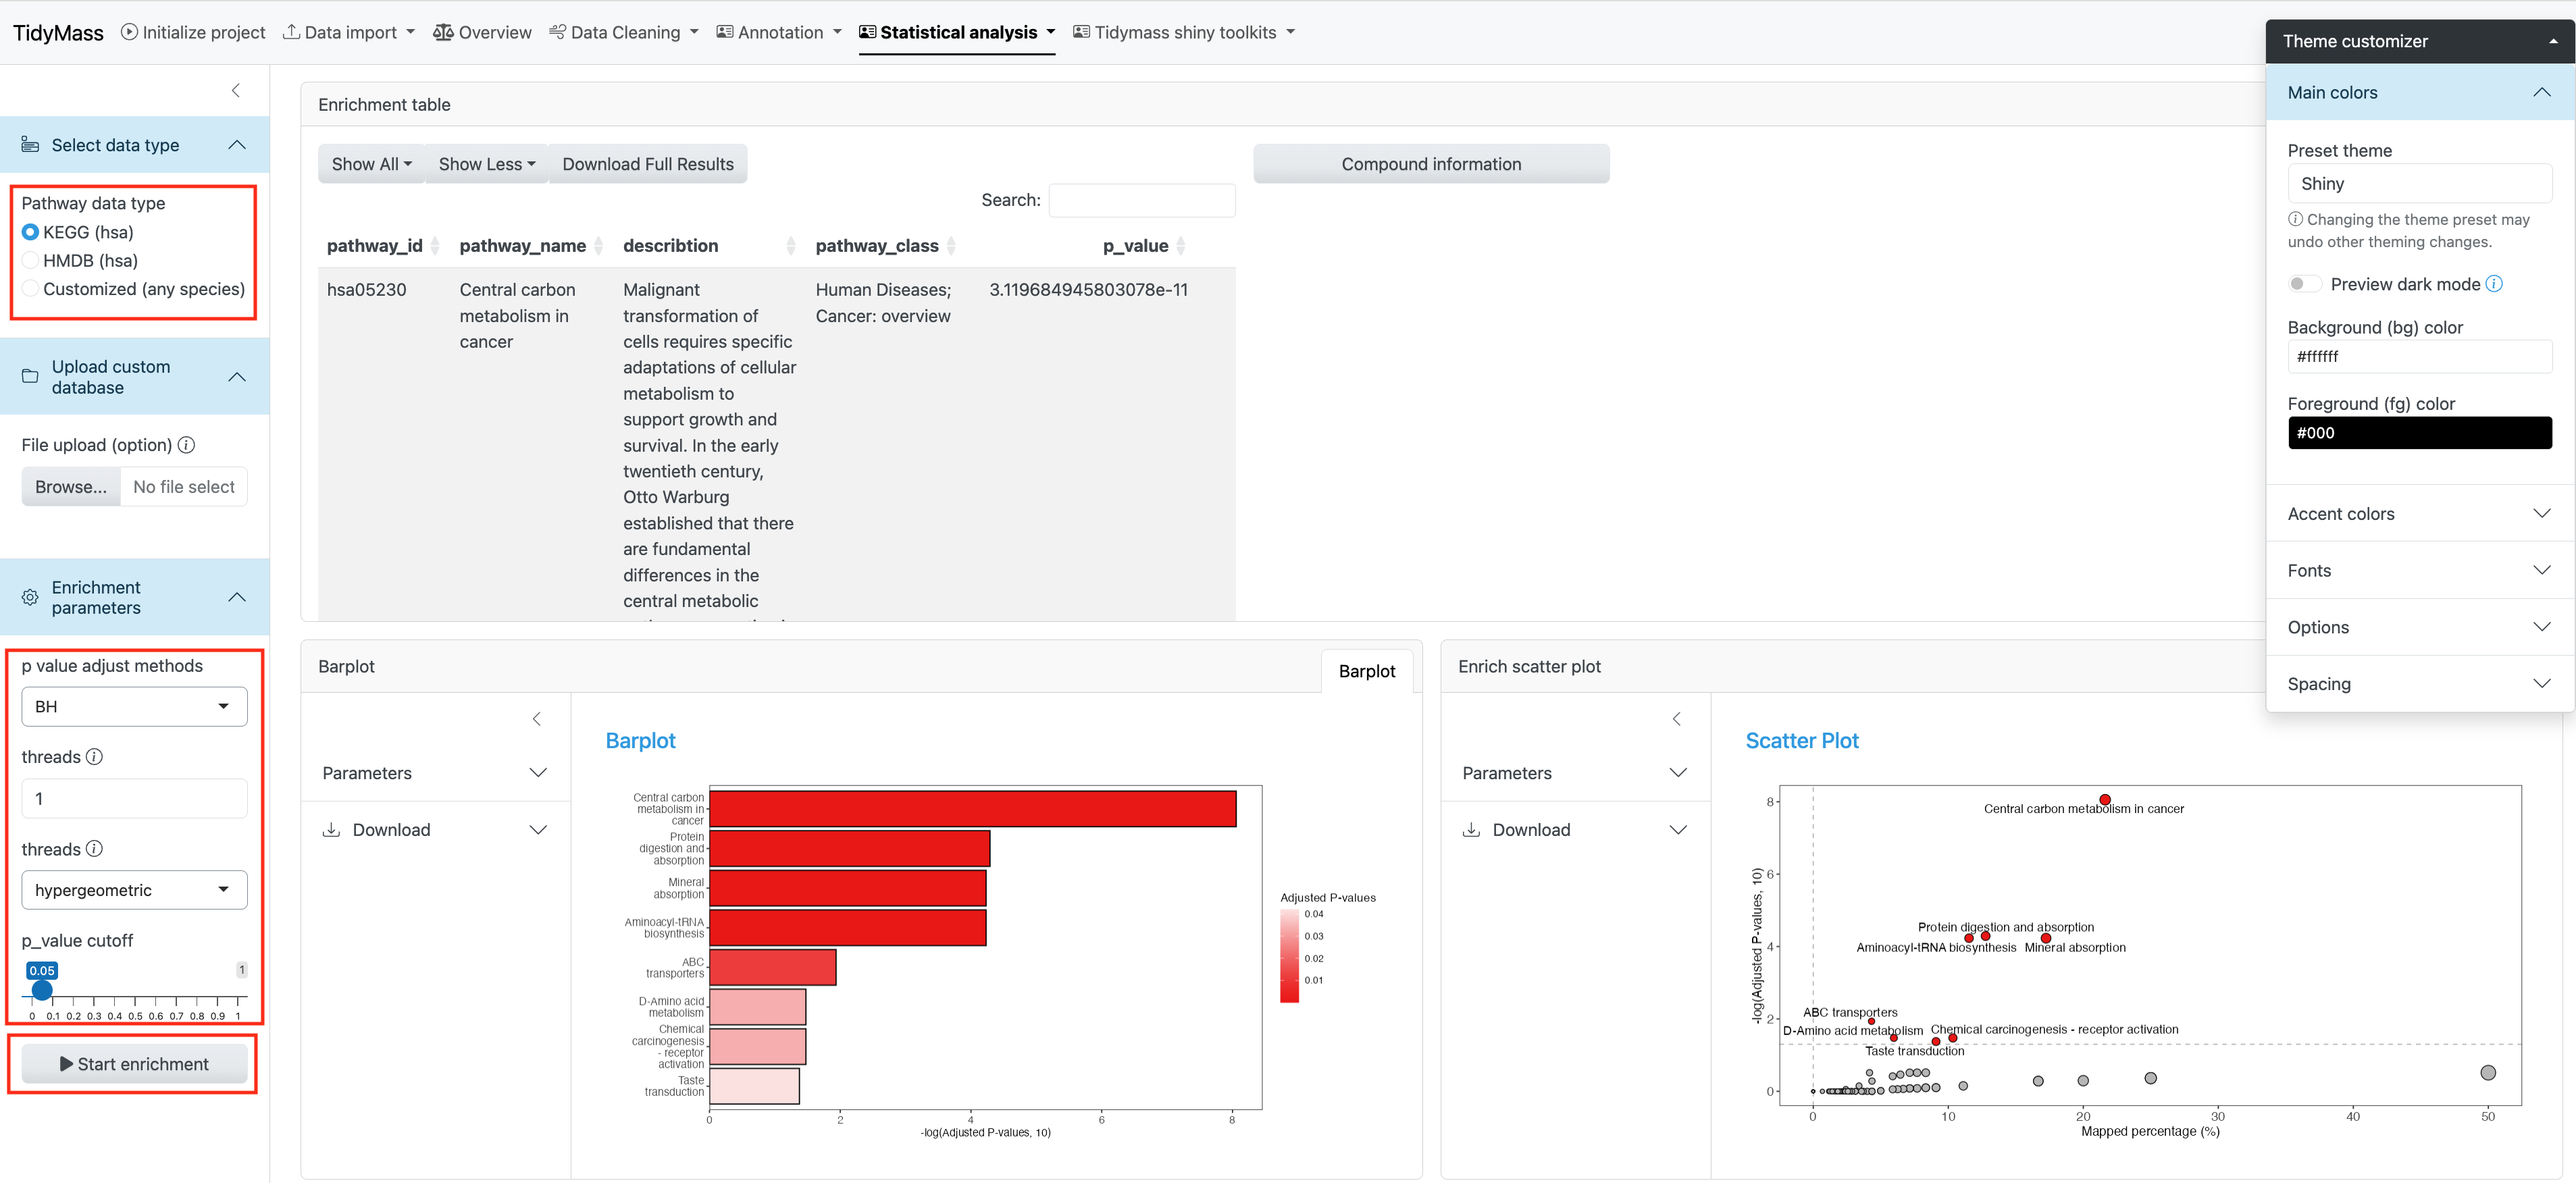
- 选择适合物种的数据库。图中的 KEGG (hsa) 对应人类,其他物种应使用相应资源。
- 设置校正方法、检验和阈值,再 Start enrichment。阅读通路表时同步核对已映射化合物和背景假设。
- 下载完整结果,不只保存条形图。视觉效果较大或通路名称中含疾病,并不能证明研究中的因果关系。